


I motori di ricerca sono la porta d'accesso al web, ma come riescono a trovare, capire e classificare miliardi di pagine? Il loro funzionamento si basa su un processo continuo e metodico in tre fasi: prima scoprono i contenuti (crawling), poi li archiviano in un indice gigantesco (indicizzazione) e, infine, li ordinano per restituire i risultati più pertinenti a chi cerca (ranking).
- Come i motori di ricerca decifrano il web
- La fase di crawling, ovvero la scoperta dei contenuti
- Indicizzazione: archiviare le pagine nel grande database di Google
- Ranking: come Google classifica i risultati di ricerca
- Gli strumenti pratici per monitorare e ottimizzare il tuo sito
- Gli errori più comuni che frenano il tuo posizionamento (e come evitarli)
- Domande frequenti: i dubbi più comuni sul funzionamento dei motori di ricerca
Come i motori di ricerca decifrano il web
Proviamo a immaginare i motori di ricerca come una biblioteca digitale sconfinata, aperta 24 ore su 24. Ma come fa a catalogare e organizzare ogni singolo "libro" (le pagine web) che viene pubblicato ogni secondo? Chiaramente, non navigano il web come facciamo noi. Usano invece un esercito di instancabili "bibliotecari" automatici, conosciuti come crawler o spider, che esplorano la rete senza sosta.
Questo processo, apparentemente magico, si fonda su tre pilastri che decidono il destino online di qualsiasi sito. Capirli è il primo passo per fare SEO sul serio.
Il viaggio dalla scoperta al posizionamento
Tutto inizia con la scoperta, o crawling. Gli spider partono da un elenco di pagine note e seguono i link che trovano per passare da una pagina all'altra, proprio come farebbe un esploratore. In questo modo, mappano costantemente il web, trovando nuovi contenuti e aggiornamenti di quelli esistenti. La loro efficacia, però, dipende molto da come è costruito il tuo sito: una buona architettura interna funziona come una mappa chiara per questi esploratori digitali.

Dopo aver scoperto una pagina, arriva l'indicizzazione. A questo punto, Google analizza il contenuto di ogni pagina – testi, immagini, video – per capire di cosa parla. Dopodiché, archivia queste informazioni nel suo indice, una sorta di schedario globale immenso che gli permette di trovare le pagine giuste in una frazione di secondo quando qualcuno fa una ricerca.
L'ultimo tassello del puzzle è il ranking, la classifica vera e propria. Quando un utente digita una query, Google interroga il suo indice e, attraverso un algoritmo incredibilmente complesso, stabilisce quali pagine sono le risposte migliori e in che ordine mostrarle.
L'immagine qui sotto riassume visivamente questo flusso, che trasforma il caos del web in risultati di ricerca ordinati e utili.
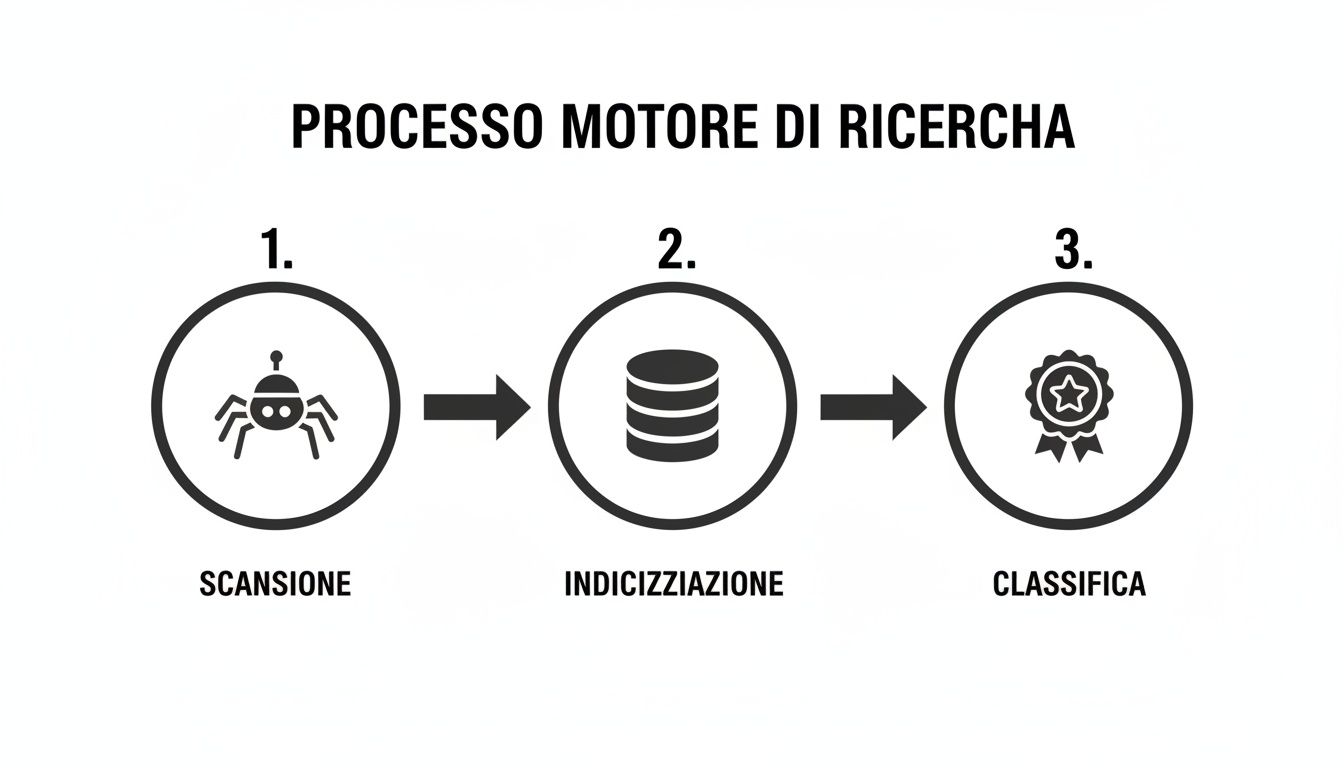
Questo processo sequenziale – scansione, indicizzazione e classificazione – è il cuore pulsante di ogni motore di ricerca e, di conseguenza, il campo di gioco della SEO.

Per rendere il tutto ancora più chiaro, ecco una tabella che riassume le tre fasi chiave.
Le 3 Fasi Chiave del Funzionamento dei Motori di Ricerca
Una panoramica sintetica delle tre fasi principali attraverso cui i motori di ricerca organizzano le informazioni del web.
| Fase | Obiettivo Principale | Metafora del Bibliotecario |
|---|---|---|
| Crawling | Scoprire nuove pagine web e aggiornamenti seguendo i link. | Il bibliotecario esplora la biblioteca scaffale per scaffale, alla ricerca di nuovi libri o edizioni aggiornate. |
| Indicizzazione | Analizzare, capire e archiviare i contenuti delle pagine in un gigantesco database. | Dopo aver trovato un libro, il bibliotecario lo legge, ne capisce l'argomento e lo scheda nel catalogo generale. |
| Ranking | Ordinare le pagine indicizzate in base alla loro rilevanza per una specifica ricerca. | Quando un utente chiede un libro su un certo argomento, il bibliotecario consulta il catalogo e consiglia i testi migliori e più autorevoli. |
In pratica, senza crawling non c'è indicizzazione e senza indicizzazione non c'è possibilità di ranking. Ogni fase è propedeutica alla successiva.

L'impatto dei motori di ricerca in Italia
Questo meccanismo è più importante che mai nel contesto italiano, dove Google domina la scena con una quota di mercato del 92,87%. Dei 53,1 milioni di italiani online, quasi tutti usano Google per le loro ricerche, che vengono processate proprio attraverso questo sistema.
Non a caso, il 41,5% degli utenti in Italia usa Google per scoprire nuovi brand. Se vuoi approfondire, puoi trovare altri dati interessanti nella ricerca completa del 2024 sulle abitudini digitali in Italia.
Capire queste fondamenta è il primo passo per trasformare la SEO da un concetto astratto a uno strumento di business concreto.
La fase di crawling, ovvero la scoperta dei contenuti
Il primo passo, quello da cui tutto comincia, è la scoperta. Puoi avere il contenuto migliore del mondo, ma se Google non lo trova, è come se non esistesse. Questa fase iniziale si chiama crawling: un'esplorazione continua e instancabile del web fatta da programmi automatici, meglio noti come crawler o spider.
Immagina questi spider come degli esploratori digitali che non si fermano mai. Partono da una lista di siti web già conosciuti e, da lì, seguono ogni singolo link che trovano, un po' come un esploratore seguirebbe un sentiero in una giungla immensa. Ogni link è una porta che conduce a una nuova pagina, un nuovo contenuto da mappare e analizzare. È grazie a questo viaggio perpetuo che i motori di ricerca scoprono siti nuovi, si accorgono degli aggiornamenti sulle pagine esistenti e rimuovono quelle ormai obsolete.
Attenzione però, le energie di questi esploratori non sono infinite. Google assegna a ogni sito un "budget" di esplorazione, il famoso crawl budget: in pratica, è la quantità di tempo e risorse che Googlebot (lo spider di Google) dedica alla scansione del tuo sito. Un sito web ben strutturato, veloce e senza errori tecnici sfrutterà al meglio il suo crawl budget, garantendo che le pagine più importanti vengano trovate senza fatica.
Come gli spider esplorano il web
Gli spider non "vedono" le pagine come noi. Invece di guardare la grafica, leggono il codice sorgente (HTML, CSS, JavaScript) per capire la struttura, il contenuto e le connessioni di ogni pagina. In parole povere, seguono sistematicamente i link <a> con l'attributo href per saltare da una risorsa all'altra.
Questo processo è cruciale per capire come i motori di ricerca trovano e classificano i siti web. Se una pagina non riceve nessun link interno da altre pagine del tuo sito (diventando una "pagina orfana"), lo spider potrebbe non trovarla mai. Di conseguenza, quella pagina non verrà indicizzata e non comparirà mai nei risultati di ricerca.
Per fortuna, hai a disposizione due strumenti fondamentali per dialogare con i crawler e guidarli nel loro lavoro: il file robots.txt e la Sitemap XML.
Dare indicazioni con il file robots.txt
Il file robots.txt è la prima cosa che un crawler cerca quando arriva su un sito. Si tratta di un semplice file di testo che funziona come un set di regole, o più semplicemente, come un cartello di "divieto d'accesso" per specifiche aree del tuo sito.
Puoi usarlo, ad esempio, per dire ai crawler di ignorare sezioni non rilevanti come le pagine di login per l'amministrazione, i carrelli della spesa o le pagine dei risultati di ricerca interni. In questo modo, li aiuti a concentrare il loro prezioso crawl budget solo sulle pagine che contano davvero, quelle che vuoi che i tuoi utenti trovino.
Ecco un esempio di file robots.txt:
User-agent: *
Disallow: /admin/
Disallow: /carrello/
In questo caso, si sta dicendo a qualsiasi crawler (User-agent: *) di non accedere (Disallow) alle directory /admin/ e /carrello/. È un'istruzione potente che, se usata male, può rendere intere sezioni del sito invisibili a Google.
Fornire una mappa con la Sitemap XML
Se il file robots.txt dice ai crawler dove non andare, la Sitemap XML fa l'esatto opposto: è una mappa dettagliata che indica loro tutte le pagine importanti che vuoi far scoprire e indicizzare. Pensala come una mappa del tesoro che guida gli spider dritti ai tuoi contenuti più preziosi.
Una sitemap fatta bene aiuta Google a:
- Scoprire subito le nuove pagine: ogni volta che pubblichi un articolo o un prodotto, la sitemap lo segnala a Google in tempi brevi.
- Capire la struttura del sito: aiuta il motore di ricerca a farsi un'idea della gerarchia e dell'importanza delle tue pagine.
- Trovare contenuti "nascosti": assicura che anche le pagine con pochi link interni vengano scoperte senza problemi.
Gestire correttamente robots.txt e sitemap XML è una mossa strategica. Non solo semplifichi il lavoro dei crawler, ma ottimizzi anche le risorse che Google dedica al tuo sito, gettando le fondamenta per un'indicizzazione solida e un buon posizionamento. Se vuoi scavare più a fondo, puoi leggere di più su cosa sono e cosa fanno gli spider dei motori di ricerca.
Indicizzazione: archiviare le pagine nel grande database di Google
Essere scoperti dai crawler è solo l'inizio. Una volta che lo spider ha "visitato" una pagina, questa deve essere compresa e archiviata in modo che Google possa tirarla fuori al momento giusto, cioè quando un utente la cerca. Questa è la fase di indicizzazione: il processo con cui Google analizza, cataloga e memorizza le informazioni delle pagine web nel suo immenso database, l'Indice.
Torniamo all'esempio del nostro bibliotecario digitale. Dopo aver scovato un nuovo libro (il crawling), ora deve leggerlo attentamente per capire di cosa parla, dare un'occhiata alle immagini, analizzare i video e, infine, registrarlo in uno schedario gigantesco e super organizzato. Questo "schedario" è l'Indice di Google, una biblioteca che contiene centinaia di miliardi di pagine web e occupa uno spazio di oltre 100.000.000 di gigabyte.
Senza indicizzazione, una pagina non potrà mai apparire nei risultati di ricerca, anche se è stata scansionata. È il passaggio cruciale che trasforma un contenuto appena scoperto in una potenziale risposta a una domanda dell'utente.
Il rendering e il mobile-first indexing: come Google "vede" il tuo sito
Ma in che modo Google "legge" una pagina? Di certo non si limita a scorrere il testo. Esegue un processo chiamato rendering, durante il quale un sistema chiamato Google Caffeine esegue il codice della pagina (HTML, CSS, JavaScript) per visualizzarla proprio come farebbe un browser. Questo permette a Google di vedere la pagina quasi esattamente come la vede un utente, capendone layout, struttura ed elementi interattivi.
Oggi questo processo ha una priorità assoluta: il mobile. Dal 2018, infatti, Google usa il mobile-first indexing. Significa semplicemente che, per la maggior parte dei siti, è la versione mobile della pagina a essere usata sia per l'indicizzazione che per il ranking.
In un mercato come quello italiano, dove il 94,8% degli accessi a internet avviene da smartphone, questa scelta è tutto fuorché casuale. Avere un sito ottimizzato per i dispositivi mobili non è più un plus, è un requisito fondamentale per esistere online.
In poche parole: se il tuo sito non funziona a dovere su smartphone, le sue possibilità di posizionarsi bene sono davvero poche.
Come Google interpreta i contenuti
Una volta che la pagina è stata renderizzata, Google ne analizza gli elementi chiave per classificarne l'argomento e la qualità. È un passaggio chiave per capire come i motori di ricerca trovano e classificano i siti web. Gli elementi passati al setaccio includono:
- Contenuti testuali: I paragrafi, i titoli (H1, H2, ecc.) e le parole usate nel testo.
- Attributi chiave: I tag
<title>e la meta description. - Elementi multimediali: Analisi delle immagini (tramite testo alternativo e riconoscimento visivo), video e file audio.
- Link: Sia i link interni che quelli che puntano verso altri siti vengono valutati per capire il contesto generale.
Tutta questa analisi è potenziata da algoritmi sempre più sofisticati, come BERT (introdotto nel 2019) e MUM (del 2021). Questi sistemi aiutano Google a interpretare il linguaggio naturale e l'intento che si nasconde dietro le ricerche degli utenti, per fornire risposte sempre più pertinenti. Per approfondire, puoi trovare tante statistiche SEO interessanti su aioseo.com.
Dare istruzioni a Google con i meta tag
Non sempre vorrai che ogni singola pagina del tuo sito finisca nell'indice di Google. Pensa alle pagine di ringraziamento dopo un acquisto, alle aree di amministrazione, ai risultati di una ricerca interna o alle bozze degli articoli. Sono tutti contenuti che è meglio tenere privati. Per fortuna, hai uno strumento molto potente per farlo: i meta tag.
Il meta tag robots è una direttiva che puoi inserire nell'HTML di una pagina per dare istruzioni precise ai crawler. Le due più comuni sono:
index: Dice a Google di indicizzare la pagina (questa è l'impostazione predefinita, quindi non serve specificarla).noindex: Chiede esplicitamente a Google di non includere la pagina nel suo indice.
Ad esempio, inserendo <meta name="robots" content="noindex"> nella sezione <head> del tuo codice HTML, stai comunicando a Google: "Grazie per la visita, ma per favore, non archiviare questa pagina". Questo ti dà un controllo granulare su ciò che viene mostrato al pubblico, permettendoti di gestire la tua visibilità in modo attivo e strategico.
Ranking: come Google classifica i risultati di ricerca
Siamo arrivati al momento clou: il ranking. Dopo aver scansionato e messo in archivio miliardi di pagine, come fa Google a decidere quali sono le 10 migliori da mostrarti per prime? Non è affatto magia, ma un sistema incredibilmente sofisticato che valuta centinaia di segnali per decidere chi merita di salire sul podio. Questo è il vero cuore del meccanismo che spiega come i motori di ricerca trovano e classificano i siti web.
Anche se l'algoritmo di ranking è spesso visto come una "scatola nera", i suoi principi di base sono piuttosto chiari. L'obiettivo di Google è uno e uno soltanto: darti la risposta migliore, più utile e affidabile, nel minor tempo possibile. Per riuscirci, esamina ogni pagina sotto diversi punti di vista, che possiamo raggruppare in quattro aree fondamentali.
La qualità e la rilevanza dei contenuti
Partiamo dalle basi: il contenuto regna ancora sovrano. Per avere una possibilità di posizionarsi, una pagina deve essere prima di tutto super rilevante per quello che l'utente ha cercato. Google analizza il testo, i titoli, le immagini e l'intera struttura per capire se la pagina risponde davvero alla domanda. Oggi non basta più infarcire il testo di parole chiave; bisogna coprire l'argomento in modo completo e soddisfare l'intento di ricerca dell'utente.
Un contenuto di qualità, per Google, è quello che:
- Va dritto al punto, rispondendo alla domanda in modo chiaro e preciso.
- È scritto bene, si legge facilmente ed è privo di errori.
- Offre qualcosa di unico, che siano dati originali, analisi approfondite o una prospettiva nuova.
In poche parole, Google premia le pagine create per le persone, non solo per i suoi algoritmi.
L'autorevolezza e i link di qualità
Un contenuto eccezionale, da solo, non è sufficiente. Deve anche essere autorevole. E come fa Google a misurare l'autorevolezza? Da sempre, si affida a un concetto chiave: i link. Ogni link che il tuo sito riceve da un'altra pagina web (chiamato backlink) è interpretato come un voto, una sorta di raccomandazione.
Più siti autorevoli e pertinenti nel tuo settore ti linkano, più Google ti vedrà come una fonte affidabile, degna di stare in cima ai risultati. Questo è il principio su cui si fonda il famoso PageRank, l'algoritmo che ha dato inizio a tutto.
Ovviamente, non tutti i link hanno lo stesso peso. Un singolo link da una testata di settore super rispettata vale infinitamente di più di cento link da siti sconosciuti o irrilevanti. La SEO, quindi, non è una corsa ad accumulare link a caso, ma a guadagnarsi "voti" di qualità che confermino la tua competenza. Se sei alle prime armi, ti consiglio di approfondire il concetto leggendo una spiegazione semplice del PageRank di Google.
Performance tecniche e sicurezza
Per puntare in alto, un sito web deve funzionare alla perfezione. Gli aspetti tecnici sono segnali chiarissimi per Google sulla qualità dell'infrastruttura che ospita i tuoi contenuti.
I fattori più critici includono:
- Velocità di caricamento: Le pagine lente sono una frustrazione per gli utenti e un semaforo rosso per Google. Un sito veloce non è un'opzione, è un obbligo.
- Ottimizzazione per il mobile: Come abbiamo visto, Google usa la versione mobile del tuo sito per l'indicizzazione. Se l'esperienza su smartphone è pessima, parti già sconfitto.
- Sicurezza (HTTPS): L'uso del protocollo HTTPS, che assicura una connessione crittografata e sicura, è un segnale di ranking confermato da anni.
Trascurare questi dettagli tecnici significa partire con un enorme handicap.
Esperienza utente e Core Web Vitals
Strettamente legata alle performance c'è l'esperienza utente (UX). Google vuole che i siti in cima alla classifica siano piacevoli e facili da usare. Per misurare questo aspetto in modo oggettivo, ha introdotto i Core Web Vitals.
Queste tre metriche misurano aspetti precisi dell'esperienza di caricamento di una pagina:
- Largest Contentful Paint (LCP): Misura la velocità con cui viene caricato l'elemento più grande visibile sullo schermo.
- First Input Delay (FID): Misura la reattività della pagina alla prima interazione dell'utente (un clic o un tocco).
- Cumulative Layout Shift (CLS): Misura la stabilità visiva, ovvero quanto gli elementi della pagina si spostano in modo inaspettato mentre si carica.
Ottenere un buon punteggio su questi tre fronti è un chiaro segnale per Google che il tuo sito offre un'esperienza fluida e senza intoppi.
E-E-A-T: la metrica della fiducia
Infine, Google valuta la qualità complessiva di un sito attraverso un modello concettuale chiamato E-E-A-T:
- Experience (Esperienza diretta sull'argomento)
- Expertise (Competenza)
- Authoritativeness (Autorevolezza)
- Trustworthiness (Affidabilità)
Questo non è un fattore di ranking diretto, ma una guida che i quality rater umani di Google usano per valutare la qualità dei risultati. Per argomenti delicati come finanza o salute (i cosiddetti "Your Money or Your Life" - YMYL), dimostrare un livello altissimo di E-E-A-T è assolutamente vitale. Dimostrare competenza, costruire autorevolezza e guadagnarsi la fiducia degli utenti non è solo una buona pratica, è la strategia vincente a lungo termine.
Gli strumenti pratici per monitorare e ottimizzare il tuo sito
Bene, dopo tutta la teoria su crawling, indicizzazione e ranking, è arrivato il momento di rimboccarsi le maniche. Per capire davvero come i motori di ricerca vedono e valutano il tuo sito, devi imparare a "spiare" il loro lavoro, quasi come se potessi metterti nei panni di un bot. Fortunatamente, esistono strumenti potentissimi (e spesso gratuiti) che ti trasformano da semplice spettatore a protagonista della tua SEO.
Padroneggiare questi tool significa avere il polso della situazione, diagnosticare problemi prima che diventino gravi e trasformare dati grezzi in strategie vincenti.
Google Search Console: il filo diretto con Google
Il primo strumento che devi assolutamente conoscere è Google Search Console (GSC). È una piattaforma gratuita che Google mette a disposizione per creare un canale di comunicazione diretto tra te e il motore di ricerca. Immaginala come il cruscotto della tua auto: ti dice a che velocità vai, se c'è qualche spia accesa e ti dà tutte le informazioni per guidare in sicurezza.
Con GSC tra le mani, puoi fare cose fondamentali come:
- Inviare la tua sitemap XML: In pratica, gli consegni una mappa del tuo sito per assicurarti che non si perda nessuna pagina importante.
- Controllare lo stato di indicizzazione: Puoi chiedere a Google: "Ehi, questa mia URL è nel tuo indice?". E lui ti risponde, dicendoti anche se ci sono stati problemi.
- Scovare errori di scansione: Ti avvisa se il Googlebot ha trovato un "muro", come un errore 404, mentre cercava di visitare una pagina.
- Analizzare le performance di ricerca: Ti svela con quali parole chiave le persone ti trovano, quante volte appari nei risultati (impressioni) e quanti clic ottieni.
La schermata principale di Google Search Console ti dà subito un colpo d'occhio sulle metriche essenziali.
Questa dashboard è il tuo punto di partenza: clic, impressioni, dati sull'esperienza utente. Tutto quello che ti serve per una prima diagnosi della salute SEO del tuo sito.
Analisi dei file di log per spiare Googlebot
Se vuoi passare al livello successivo, c'è una tecnica più da "detective": l'analisi dei file di log. Ogni singola volta che un crawler (o un utente) visita il tuo sito, il server registra l'evento in un file di testo. Leggere questi file è come sbirciare nel diario segreto di Googlebot.
Scopri quali pagine scansiona più spesso, quali ignora completamente e se sta sprecando risorse preziose (il famoso crawl budget) su URL inutili. È un'analisi che porta alla luce problemi altrimenti invisibili e ti permette di intervenire con una precisione chirurgica. Se ti interessa l'argomento, puoi approfondire cosa può dirti il rapporto di Google Search Console in un nostro articolo dedicato.
I crawler SEO per un check-up completo
Infine, ci sono i cosiddetti crawler SEO. Si tratta di software di terze parti (come Screaming Frog o Sitebulb) che si comportano esattamente come gli spider dei motori di ricerca. Lanci una scansione e loro esplorano il tuo sito in lungo e in largo, restituendoti un report dettagliatissimo su ogni aspetto tecnico.
Usare un crawler SEO è come sottoporre il tuo sito a una TAC. Rivela fratture e problemi invisibili a occhio nudo che però possono compromettere seriamente le tue performance.
Questi strumenti sono oro colato per individuare:
- Link rotti (sia interni che esterni).
- Contenuti duplicati o meta title identici.
- Redirect impostati male o che creano catene infinite.
- Immagini pesantissime che inchiodano il caricamento delle pagine.
Mettendo insieme la visione d'insieme di Google Search Console, i dettagli investigativi dei file di log e l'analisi tecnica di un crawler, avrai un arsenale completo. Potrai così ottimizzare ogni singola fase del processo e dare una spinta decisiva al tuo posizionamento.
Gli errori più comuni che frenano il tuo posizionamento (e come evitarli)
A volte, il motivo per cui un sito fatica a decollare non è una concorrenza agguerrita, ma una serie di errori tecnici che, per fortuna, si possono risolvere abbastanza facilmente. Superare questi ostacoli è il primo passo per capire davvero come i motori di ricerca trovano e classificano i siti web.
Vediamo insieme quali sono le trappole più comuni che rischiano di sabotare la tua visibilità e, soprattutto, come puoi uscirne. Mettendo mano a questi problemi, potrai finalmente liberare tutto il potenziale del tuo sito.
Bloccare per sbaglio i crawler
Uno degli errori più gravi, e purtroppo diffusi, è quello di ostacolare il lavoro degli spider. Basta un file robots.txt configurato male per fare un disastro. Una singola riga di codice sbagliata, come Disallow: /, può rendere l'intero sito invisibile a Google. È un po' come chiudere a chiave la porta del tuo negozio e sperare che i clienti entrino lo stesso.
È fondamentale dare un'occhiata a questo file ogni tanto. Assicurati che dia libero accesso a tutte le aree importanti del sito e che blocchi solo le sezioni che devono rimanere private, come le pagine di amministrazione o i carrelli degli utenti.
Trascurare la qualità dei contenuti
Un altro scivolone classico è pubblicare contenuti scarni, superficiali o di bassa qualità. In gergo li chiamiamo "thin content". Pagine con poche righe di testo, contenuti palesemente copiati o articoli che non rispondono in modo completo alle domande degli utenti mandano un segnale pessimo a Google.
Per un motore di ricerca, un sito pieno di "thin content" ha poco o nessun valore da offrire. E allora perché mai dovrebbe mostrarlo tra i primi risultati? La qualità e la profondità dei tuoi articoli sono un investimento diretto nel tuo posizionamento.
Prendersi il tempo per creare contenuti completi, originali e davvero utili è la strategia più sicura per dimostrare autorevolezza e soddisfare sia le persone che gli algoritmi.
Avere un'architettura del sito confusionaria
Una struttura del sito caotica e disorganizzata è un problema per due motivi. Primo, confonde gli utenti, che non trovano quello che cercano e se ne vanno frustrati. Secondo, disorienta gli spider dei motori di ricerca.
Se i crawler non riescono a navigare con facilità tra le tue pagine, seguendo una gerarchia logica di link interni, potrebbero non scoprire (e quindi non indicizzare) alcuni dei tuoi contenuti più preziosi. Un'architettura chiara, con categorie ben definite e una navigazione intuitiva, è semplicemente imprescindibile.
Ignorare l'esperienza da mobile
Nell'era del mobile-first indexing, avere un sito che funziona male su smartphone è un suicidio SEO. Google oggi valuta e classifica il tuo sito basandosi prima di tutto sulla sua versione per dispositivi mobili. Se questa versione è lenta, difficile da navigare o il testo è illeggibile, il tuo ranking ne pagherà le conseguenze. E saranno pesanti.
Avere un sito responsive, che offra un'esperienza utente impeccabile su ogni dispositivo, non è più una scelta. È un requisito fondamentale per poter competere online.
Domande frequenti: i dubbi più comuni sul funzionamento dei motori di ricerca
Per fare il punto sui concetti chiave e chiarire ogni possibile dubbio, ecco le risposte alle domande che ci vengono poste più spesso su come i motori di ricerca scoprono e classificano i siti web.
Che differenza c'è tra crawling e indicizzazione?
Immagina il crawling come la fase di esplorazione: uno spider (o crawler) naviga il web seguendo i link per scoprire pagine nuove o aggiornate, proprio come un esploratore che mappa un territorio sconosciuto.
L'indicizzazione è il passo successivo, quello dell'archiviazione. Dopo aver scoperto una pagina, Google ne analizza il contenuto e la inserisce nel suo gigantesco database. In pratica, se il crawling trova le porte, l'indicizzazione le apre e cataloga tutto ciò che c'è dentro per renderlo trovabile.
Quanto ci mette Google a indicizzare una nuova pagina?
Non esiste un tempo standard. Il processo può durare da poche ore a diverse settimane. La velocità dipende molto dall'autorevolezza del tuo sito, dalla frequenza con cui pubblichi nuovi contenuti e da quanto è facile per i crawler trovare la pagina (ad esempio, grazie a una sitemap XML aggiornata o a link interni da pagine importanti).
Cos'è esattamente uno spider o crawler?
Uno spider, chiamato anche crawler, è un programma automatico – un "bot" – che i motori di ricerca usano per scandagliare il web. Il suo unico compito è visitare siti, leggere il codice delle pagine e seguire tutti i link che trova per scoprire nuovi contenuti. L'insieme delle pagine che gli spider scoprono va a formare l'indice del motore di ricerca.
Un sito può essere visibile anche senza una sitemap?
Assolutamente sì. Un sito può essere trovato e indicizzato anche senza una sitemap, a patto che abbia una buona struttura di link interni e riceva collegamenti da altri siti già conosciuti da Google.
Detto questo, una sitemap XML è sempre una mossa intelligente. Pensa a essa come a una mappa dettagliata che fornisci direttamente agli spider, assicurandoti che trovino tutte le tue pagine importanti in modo rapido e senza perdersi nulla per strada.
Il file robots.txt è obbligatorio?
No, non è obbligatorio. Se il tuo sito non ha un file robots.txt, i crawler daranno per scontato di poter scansionare ogni singola pagina che trovano.
Averlo, però, è una best practice fondamentale. Ti permette di bloccare l'accesso a sezioni che non vuoi mostrare nei risultati di ricerca (come aree amministrative o pagine di test), ottimizzando così il crawl budget, cioè il tempo e le risorse che Google dedica alla scansione del tuo sito.
Come faccio a sapere se il mio sito è indicizzato?
Il modo più rapido e affidabile è usare Google Search Console. Lo strumento "Controllo URL" ti consente di inserire l'indirizzo di qualsiasi pagina e ti dice subito se è nell'indice di Google o se ci sono problemi.
Un'alternativa più semplice, anche se meno dettagliata, è fare una ricerca su Google con l'operatore site:, ad esempio site:iltuosito.it. Questo comando ti mostrerà un elenco di tutte le pagine del tuo dominio che Google ha indicizzato.
Speriamo che questa guida ti abbia aiutato a fare chiarezza sul complesso mondo dei motori di ricerca. Se vuoi passare dalla teoria alla pratica e ottenere risultati concreti, Seowebsite offre guide, strumenti e servizi personalizzati per far decollare la tua visibilità online. Scopri di più su https://www.seowebsite.it.


